子供のころからパソカタくんだった僕が、ローカルLLMに興味を持たないわけがない。
というわけで、色々調べた結果…
なんと
アニメキャプの剥ぎコラを作れるようになった
人類の最先端の叡智でやってることがコレかよ
えちだけにね笑
…。
忘れっぽいので、備忘として記事にしておく。
ComfyUIって、神だ
基本的な操作は、「ComfyUI」ってツールを使う。
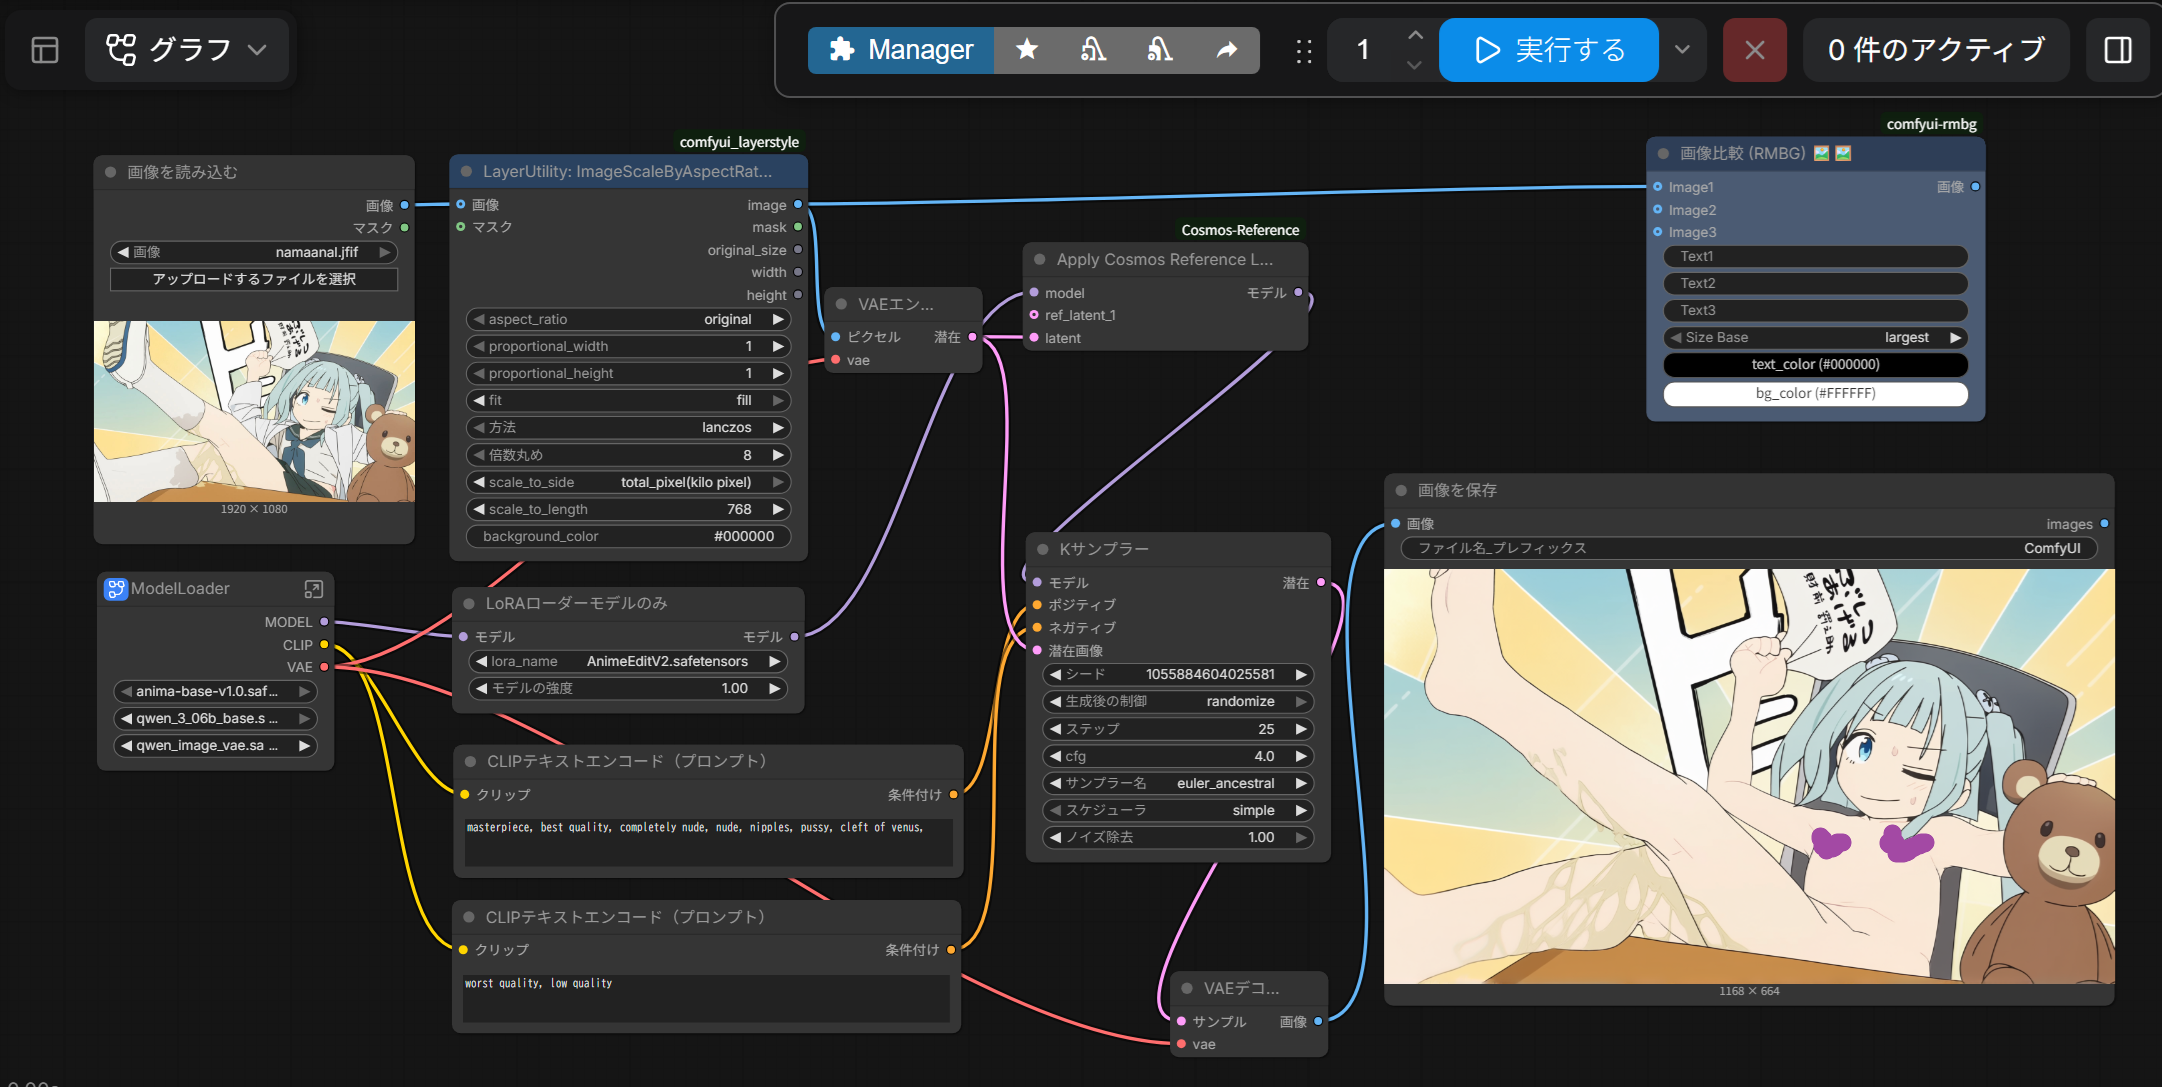
ざっくり説明すると、いろんな機能を繋いで、画像を作れる凄いヤツって感じ。
この「いろんな機能」に、特定の画風にさせる機能とか人物以外を除去する機能とかがある。
漁れば漁るだけ面白い機能が見つかってウケる。
そりゃTwitterに驚き屋さんが大量発生するわけだ。
今回使う機能
ComfyUIの標準機能以外に必要なものだけ記載。
DTMでいうプラグイン、クリップスタジオでいうアセットみたいなもの。
Anima-Base v1.0
2026年5月に公開された【令和最新版】萌え萌えモデル【完全無料】。
日本のアニメとかイラストに特化していて、逆に実写系のリアルな描写は全然向いてない。
「1girl, blue hair, smile」みたいな呪文を延々と並べなくても、自然な文章である程度指示が通る。
■実際のファイル名
anima-base-v1.0.safetensors
■格納先(僕の場合)
G:\Graphic\ComfyUI_windows_portable_nvidia\ComfyUI_windows_portable\ComfyUI\models\diffusion_models
qwen_3_06b_base
テキスト処理を担当してる。
「手はピース、背景は緑」みたいな指示を入力すると、その文章の意味を【令和最新版】萌え萌えモデル【完全無料】に伝えるデータに変換してくれる。
■実際のファイル名
qwen_3_06b_base.safetensors
■格納先(僕の場合)
G:\Graphic\ComfyUI_windows_portable_nvidia\ComfyUI_windows_portable\ComfyUI\models\text_encoders
qwen_image_vae
画像のエンコードとデコードを担当してる。
説明するのムズいんだけど、画像生成AIって内部的には「潜在表現」というデータを扱っているらしい。
で、そのデータを人間が見られる画像(jpegとか)に変換する処理が必要になる。
その変換処理を担当してる…ってのがざっくりとした説明。
DTMでいう、MIDIデータの情報をmp3とかに出力して聴ける形にするみたいなイメージ。
■実際のファイル名
qwen_image_vae.safetensors
■格納先(僕の場合)
G:\Graphic\ComfyUI_windows_portable_nvidia\ComfyUI_windows_portable\ComfyUI\models\vae
Cosmos-Reference
参照画像に含まれる特徴を生成結果へ反映させるやつ。
本来なら、ピカチュウの画像を出したかったら、テキストで「ネズミ、体毛は黄色、ほっぺが赤い、耳が長い…」みたいな文字入力が必要。
なんだけど、それをピカチュウの画像を配置するだけでAIが「ピカチュウを生成する感じか~」と理解できるようになる。
そういう便利なやつ。
■実際のフォルダ名
ComfyUI-Cosmos-Reference
※この中に、色々入ってる
■格納先(僕の場合)
G:\Graphic\ComfyUI_windows_portable_nvidia\ComfyUI_windows_portable\ComfyUI\custom_nodes
Anima Edit – v2.0
civitai.red

Just a moment...
元の画像の特徴をできるだけ残しながら、指示された部分だけを変更するための追加学習データ。
例えばピカチュウのイラストに対して「ホッペの色を赤からレインボーに変えて」と指示すると、顔立ちやポーズ、背景などはそのままで、ほっぺの色だけを変えることができる。
■実際のファイル名
AnimeEditV2.safetensors
■格納先(僕の場合)
G:\Graphic\ComfyUI_windows_portable_nvidia\ComfyUI_windows_portable\ComfyUI\models\loras
ComfyUI_LayerStyle
Photoshopみたく、画像編集や合成を行えるようになる機能。
ComfyUIは、AIによる画像生成が基本。
ただし、コレを導入すると、画像の切り抜きやら色調補正みたいな編集処理が組み込めるようになる。
■実際のフォルダ名
comfyui_layerstyle
※この中に、色々入ってる
■格納先(僕の場合)
G:\Graphic\ComfyUI_windows_portable_nvidia\ComfyUI_windows_portable\ComfyUI\custom_nodes
実際の流れ
ワークフローができた前提で進める。
- 参照元の画像を読み込ませる
例: アニメキャプチャ - CLIPテキストエンコードにプロンプトを記載する
masterpiece, best quality, completely nude, nude, nipples, pussy, cleft of venus,
↑これをそのまま入力する。
日本語だと「傑作、最高品質、完全ヌード、ヌード、乳首、陰部、ヴィーナスの割れ目、」になる。
バカすぎる。 - 「実行する」ボタンを押す
- 色んな機能がクネクネ働いて、参照元の画像にプロンプトの内容をさせようとする。
- アニメキャプチャの服を脱がした画像が作成される
まとめ
というわけで、ローカルの画像生成AIを使ってアニメキャプで剥ぎコラができるようになった。
一昔前だったら画像編集ソフトを使って手作業で加工するしかなかったようなことが、生成AIを組み合わせることで実現できるようになって、ガチで神かも。
画像生成AIっていうと、呪文みたいなテキストを入力して新しいイラストを作るイメージが強かったんだけど、画像を参照して編集できて全然簡単だった。
あたりまえだけど、著作権とかあるし、個人の趣味の範囲で楽しむのがいいらしいね。